Hadoop es una plataforma tecnológica, desarrollada por la Apache Software Foundation, desde la que acometer la complejidad del problema de los datos extremadamente grandes y/o heterogéneos. Por otra parte Azure es la plataforma de Cloud de Microsoft. Entre otros muchos servicios incorpora (de momento como developer preview) Hadoop. Esto entre otras ventajas nos va a facilitar mucho el poder probar y conocer este producto como veremos más adelante (construir un cluster con solo con unos cuantos clicks “suaviza” bastante la curva de entrada).
Volvemos al problema de los datos extremadamente grandes. ¿Qué problema es este?, ¿Qué son estos datos extremadamente grandes?
En el momento actual tenemos cada vez con más frecuencia, situaciones donde datos que podrían aportarnos una información útil, se descartan, debido al volumen excesivo de los mismos, y a lo costoso del proceso en tiempo y /o dinero. Algunos ejemplos serían: datos de redes de sensores electrónicos, volúmenes de datos generados en determinadas instalaciones científicas o industriales, logs de granjas de servidores webs. A día de hoy Hadoop se está empleando en campos como:
Búsqueda de Productos y generación de índices.
- Minería de Datos.
- Procesos de ETL.
- Análisis de datos.
- Almacenamiento y procesado de Logs.
….
- Renderizado de 3D.
Hay distintos escenarios donde Hadoop aporta valor; algunos de los grandes de internet ya lo están usando: Amazon, Ebay, Facebook, Twiter, son solo algunos nombres de una larga lista.
Gran parte de estos datos se desechan, con lo que conlleva esa pérdida de información, ya que no solo explotarlos, sino tan solo almacenarlos puede resultar muy costoso. Ante estas situaciones, aparece Hadoop, como una posible respuesta a parte de estos problemas. Se establece el tamaño mínimo de problema a tratar en el orden de cientos de Gigas, y puede irse a tamaños de problema mucho mayores (peta bytes).
Hadoop se encarga de permitir almacenar y extraer información útil de estos volúmenes ingentes de datos, utilizando para ello hardware común (pc normales, con discos normales), de una forma distribuida, robusta y sobre todo escalable. Para ello se encarga de repartir la tarea entre los distintos nodos (ordenadores) que conforman el cluster Hadoop.
Hay otras formas de abordar el tratamiento de grandes volúmenes de datos (MIP: interface de paso de mensajes por ejemplo) que rendirán mejor que Hadoop para volúmenes de datos considerados dentro de problema de BigData, pero generalmente no escalan tan bien y de una manera tan sencilla (en la programación se ha de tener en cuenta el hardware que se utiliza y al crecer el problema y el cluster de maquinas empleado para resolverlo, se ha de cambiar/adaptar el software).
Con Hadoop, una vez se ha desarrollado la solución esta correrá de sin ser modificada en cluster de distinto tamaño. Así mismo el modelo de programación que presenta Hadoop es sencillo pese a la curva de aprendizaje inicial.
Hay muchos componentes tecnológicos que conforman y dan valor al universo Hadoop. En esta introducción nos centraremos en los dos elementos que generalmente se refieren como los centrales o como el núcleo de Hadoop: Hadoop Distribute File System, y MapReduce.
HDFS: Hadoop Distributed File System
El sistema de archivos distribuido de Hadoop, se encarga de almacenar archivos que pueden ser de un tamaño gigantesco. Para ello los archivos son troceados y esos pedazos, llamados bloques, se almacenan de una forma redundante a lo largo del cluster de nodos de Hadoop, de manera que aunque un nodo no este disponible los datos sigan estando disponibles. Así mismo esta redundancia se monitoriza de cara a mantenerse el nivel de redundancia para cada bloque a lo largo del cluster (numero de replicas por defecto para el cluster, o especifico para un fichero en su creación).
Cada cluster se compone de dos tipos de servicio: un namenode, y de n datanode (al menos uno). El primero se encarga de hacer de interface con los clientes que interactúan con el sistema de ficheros, así como mantener los metadatos asociados (árbol de directorios y ficheros, permisos sobre los archivos, ubicación de los distintos bloques que conforman cada archivo,…). Lo date nodes a su vez, actúan como repositorios de los bloques que conforman los ficheros. El name node coordina las operaciones sobre los ficheros, y se encarga de monitorizar (heardbeat) en cada momento que date nodes permanecen accesibles y que bloques hay en cada uno
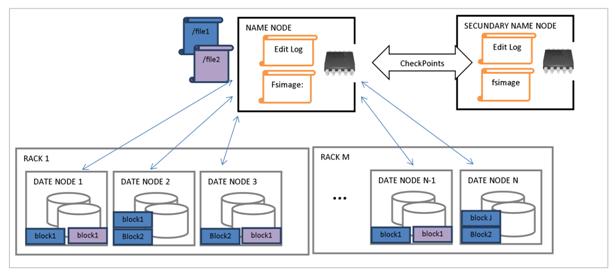
Algunos elementos a tener en cuenta dentro del sistema HDFS serán:
1º La concepción de que los datos se escriben una vez y se procesan n veces, pero no se modifican. Al no admitir modificaciones sobre los archivos, es mucho más sencillo mantener redundancia de los bloques a lo largo del cluster (en realidad no es cierto que los ficheros no se puedan modificar, ya que se pueden anexar datos a un fichero ya creado).
2º En Hadoop los ficheros se consideran orientados a registro. Esto no quiere decir que cada línea del fichero sea un registro (comportamiento por defecto), sino que el fichero se puede descomponer en elementos procesables de forma separada. Es decir se puede dividir de forma predecible en piezas de información que puedan procesarse de manera individual. Esto permite la división en bloques que se puedan procesar en paralelo (ver MapReduce).
3º En lugar de llevar los datos hasta el proceso, lo que obligaría a mover enormes volúmenes de datos y penalizaría el rendimiento y sobre todo la escalabilidad, lo que se hace es llevar el procesado de los datos hasta cada uno de los nodos del cluster donde se encuentran cada uno de los pedazos de fichero a procesar en lo que llamaremos el principio de proximidad del proceso a los datos (sin considerar la redundancia de estos pedazos).
MapReduce
Es el modelo de programación seguido en Hadoop. El funcionamiento que sigue es que se programan una serie de tareas; las más comunes son el Map y el Reduce, que dan nombre al modelo, aunque hay otros muchos elementos que se pueden programar/sobre- escribir: nuevos tipos de datos y su ordenación, parseo de la entrada, Split de los ficheros, lectura de cada record, combiner, formateo de salida,…
En lo esencial, el proceso sería más o menos:
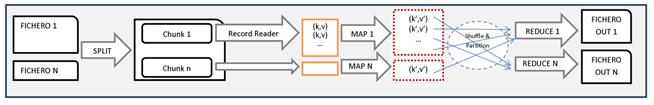
- El fichero de entrada se parte en porciones (chunk) que se procesarán en distintas tareas de mapeo; en principio el tamaño de estas porciones, coincide con el tamaño del bloque del sistema de archivos HDFS (64 MB), de cara a asignar cada tarea de mapeo al nodo que tenga localmente acceso al bloque, disminuyendo así los tiempos de acceso al fichero, así como el trafico de red.
- Cada porción de archivo es leída registro a registro, y por cada uno de ellos se extrae una tupla o pareja clave-valor (k,v).
- Cada tupla de elementos (k,v) anterior, pasa por el mapeo que , de forma general dará otra tupla o pareja clave-valor distinta de la entrada ,tanto en el valor como en los tipos de datos asociados para clave y para valor (k’ , v’).
- Las tuplas resultado de todos los mapeos, pasan por un proceso de agrupación y ordenación, entregándose a cada tarea Reduce un conjunto de estas tuplas, de tal manera que todas las tuplas con igual clave k’, se procesan en la misma tarea de Reduce.
- Las tareas de reduce reciben un conjunto de tuplas conteniendo clave-colección de valores emitidos junto con esa clave en el proceso de mapeo, lo procesan iterando por la colección de valores y generan una o varias salidas a fichero (cada reduce escribirá un fichero distinto en el directorio de salida).
La ejecución de un trabajo sobre una colección de ficheros originará una serie de tareas de Mapeo (una por cada pedazo o split a procesar, que se le solicitará a alguno de los nodos que posean copia de los datos –principio de cercanía a los datos y no tenga asignado otra tarea de mapeo).
Cuando todas las tareas de mapeo se terminan, se ejecutarán una o varias tareas de reduce (configurable en cada trabajo). Los datos llegan a estas tareas de los distintos nodos donde se ejecutan las tareas de mapeo, con lo que esta parte del proceso no se aprovecha del principio de cercanía a los datos. Por ello cuanto menor sea el volumen de información que salga de la fase de mapeo, menor será el consumo de ancho de banda del proceso, con su consiguiente beneficio en el rendimiento del trabajo.
La API original para manejar este estilo de programación (y en general los distintos elementos que componen el universo Hadoop), es una interface java, con lo que este es el lenguaje de referencia en el ecosistema Hadoop, aunque existen otras posibilidades: Hadoop Pipes (interface con C++), y Hadoop Streaming (interface con cualquier lenguaje que pueda usar entrada y salida estándar, orientado al procesado de texto línea por línea).
Además de estas dos tecnologías centrales (HDFS y MapReduce) aparecen muchas otros elementos dentro del ecosistema “Hadoop”, pero creo que como una primera aproximación es suficiente.
¿Y a partir de aquí?
Con esto hemos sentado las bases (muy teóricas eso si), que nos permitirán ir conociendo de una forma más practica y minuciosa lo que Hadoop tiene para ofrecernos, y como sacar partido de el sobre Azure.
En próximos post o videos (si el trabajo y la familia lo permiten), intentaremos:
- Demo practica sobre Azure.
- Ejemplo de programación siguiendo el modelo MapReduce.
- Otros elementos Hadoop.
- Profundizaremos en la arquitectura.
SaludOS y hasta pronto!!
Autor: Eugenio López de Elorriaga, Software developer on